Storage. Backup. Virtualisierung.


Ein Proxmox VE Ceph Cluster kombiniert Server-Virtualisierung und
verteilten Storage in einer hyperkonvergenten Infrastruktur
(HCI, Hyper-Converged Infrastructure).
Proxmox VE stellt virtuelle Maschinen mit QEMU/KVM, Linux-Container mit LXC,
Cluster-Management und Hochverfügbarkeit (HA) bereit.
Ceph verteilt die VM-Daten redundant über mehrere Storage-Nodes und stellt sie
den Proxmox-Nodes als gemeinsamen Storage zur Verfügung.
Für virtuelle Maschinen wird dabei typischerweise
Ceph RBD (RADOS Block Device) als verteilter Block-Storage genutzt.
Die virtuellen Datenträger sind dadurch nicht an den lokalen Speicher eines
einzelnen Virtualisierungs-Hosts gebunden.
Fällt ein Proxmox-Node aus, können als HA-Ressource konfigurierte virtuelle
Maschinen auf einem anderen verfügbaren Cluster-Node neu gestartet werden,
sofern das Ceph-Cluster weiterhin ausreichend verfügbar ist.
Für einen produktiven hyperkonvergenten Aufbau planen wir in der Regel
mindestens drei Proxmox-VE-Nodes.
Hardware, CPU, RAM, SSD/NVMe-Kapazität und Netzwerkinfrastruktur werden passend
zum Workload und den Anforderungen an Performance und Verfügbarkeit dimensioniert.
Proxmox VE 9.2 wurde im Mai 2026 veröffentlicht und basiert auf
Debian 13.5 „Trixie“. Zu den integrierten Komponenten gehören
unter anderem QEMU 11.0, LXC 7.0, ZFS 2.4 sowie
Ceph Tentacle 20.2.
Proxmox VE 9.2 bietet darüber hinaus Funktionen wie den Dynamic Load Balancer
für eine bessere Verteilung der Cluster-Ressourcen.
Stand dieser Seite: September 2026.
Die konkret eingesetzten Softwarestände werden bei neuen Installationen vor
der Inbetriebnahme geprüft und an die jeweilige produktive Umgebung angepasst.
Weitere Informationen:
Proxmox VE 9.2
Vorteile der Proxmox VE Virtualisierung mit Ceph
Open-Source-Software auf Debian-Linux-Basis
Subscription und Herstellersupport durch Proxmox verfügbar
Hyperkonvergenter Cluster mit Proxmox VE und Ceph
Shared Storage über Ceph RBD
Cluster mit integrierten HA-Funktionen
Virtuelle Maschinen mit QEMU/KVM und Container mit LXC
Live-Migration bei gemeinsam verfügbarem Storage
Skalierbarer Storage durch zusätzliche OSDs und Nodes
Integration von Proxmox Backup Server möglich

Die folgende Konfiguration ist ein Beispiel. CPU, Arbeitsspeicher, Datenträger, Netzwerkkarten und Gehäuse werden entsprechend den Anforderungen des Projekts und der aktuellen Hardwareverfügbarkeit dimensioniert.
Gehäuse:
19" Rackmount-Server 1HE von Supermicro
redundante Netzteile
redundante Lüfter
SSD / Festplatten:
6 x 960 GB SSD für Daten (Ceph)
2 x 480 GB SSD für Proxmox-System
bis zu 8 SFF-Laufwerke (2,5 Zoll) im Beispielgehäuse
alternativ größere Systeme mit zusätzlichen SSD-/NVMe-Slots
Netzwerkkarten:
4 × 10 GbE über 10GBASE-T in der Beispielkonfiguration
alternativ 10/25 GbE über SFP28
bei hohen Anforderungen auch 100 GbE über QSFP28
redundante Anbindung für Ceph-, VM- und Cluster-Verkehr
Hauptspeicher:
128 GB RAM in der Beispielkonfiguration
für produktive Systeme abhängig von VM-Last und Ceph-Sizing häufig 256 GB oder mehr
RAM-Bedarf von Ceph wird zusätzlich zum Speicherbedarf der VMs und Container berücksichtigt
Prozessor:
Intel- oder AMD-Serverprozessoren
Anzahl der CPUs und CPU-Kerne abhängig von VM-Last und Lizenzierungsanforderungen
ausreichende CPU-Reserve für Ceph- und Cluster-Dienste
Garantie:
verschiedene Service-Level abhängig von Server und Hersteller
bis zu 5 Jahre Hardware-Service möglich
optional Vor-Ort-Service mit definierten Reaktionszeiten
Software:
Proxmox Virtual Environment (VE)
Virtualisierung mit QEMU/KVM und LXC
Hochverfügbarkeit (HA) und Cluster-Management
Proxmox Cluster File System (pmxcfs)
Snapshots und integrierte Backup-Funktionen
PCIe-Passthrough, UEFI und TPM-Unterstützung
lokaler Storage über ZFS, Btrfs, LVM und LVM-thin
externe Storage-Protokolle wie NFS, SMB/CIFS und iSCSI
Ceph RBD und CephFS
Proxmox Backup Server optional integrierbar
Datenblatt:
Preis auf Anfrage
Projektpreise und individuelle Konfigurationen sind möglich.
Fordern Sie ein auf Ihre Anforderungen abgestimmtes Angebot an!
Alle wesentlichen Funktionen von Proxmox VE stehen unabhängig von der
Subscription-Stufe zur Verfügung. Die Subscriptions unterscheiden sich vor
allem durch den Zugriff auf stabile Enterprise-Pakete sowie den Umfang des
Herstellersupports.
Die Abrechnung erfolgt pro Jahr und belegtem physischem CPU-Sockel.
Die Anzahl der CPU-Kerne verändert den Subscription-Preis nicht.
In einem Cluster müssen alle Nodes entsprechend lizenziert werden.
| Bezeichnung | Enterprise Repository | Support | Preis zzgl. MwSt. |
|---|---|---|---|
| Frei | Nein | Kein Enterprise-Support, z. B. für Test- und Laborumgebungen | 0,00 Euro |
| Community | Ja / Alle Features | Kein Enterprise-Ticketsupport, Community-Forum | 120,00 Euro / Jahr / CPU-Sockel |
| Basic | Ja / Alle Features | 3 Tickets / Jahr, NBD | 370,00 Euro / Jahr / CPU-Sockel |
| Standard | Ja / Alle Features | 10 Tickets / Jahr, 4 Stunden BD / Remote | 550,00 Euro / Jahr / CPU-Sockel |
| Premium | Ja / Alle Features | Unlimited Tickets, 2 Stunden BD / Remote | 1.100,00 Euro / Jahr / CPU-Sockel |
Hinweis zum Herstellersupport: Proxmox hat angekündigt, den Enterprise-Support ab dem 19. Oktober 2026 um eine weltweite 24/7-Abdeckung zu erweitern. Für Premium soll die 24/7-Abdeckung ab diesem Termin enthalten sein; für Standard ist die Einführung in einem weiteren Zeitfenster im vierten Quartal 2026 angekündigt. Für Basic bleibt die bestehende SLA-Struktur bestehen. Die jeweils aktuellen Bedingungen des Herstellers sind bei Bestellung maßgeblich.


Proxmox VE - Cluster erstellen
Ceph Storage im Proxmox Cluster erstellen
Ceph Storage mit Mesh Netzwerk erstellen
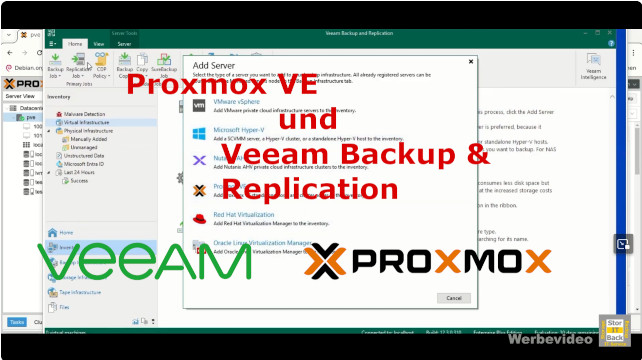
Konfiguration von Veeam Backup & Replication für Proxmox VE
Proxmox VE unterstützt unterschiedliche Storage-Architekturen.
Interne Datenträger eines Nodes können beispielsweise mit
ZFS genutzt werden. ZFS ist in einer solchen Konfiguration
zunächst lokaler Storage und kein gemeinsam von allen Nodes verwendeter
Shared Storage.
Proxmox VE kann VM-Datenträger auf lokalem ZFS über
Storage Replication asynchron auf andere Cluster-Nodes
übertragen. Hochverfügbarkeit ist deshalb grundsätzlich auch ohne Ceph
beziehungsweise klassischen Shared Storage möglich.
Zwischen zwei Replikationsläufen besteht jedoch ein mögliches
Recovery Point Objective (RPO):
Fällt ein Node ungeplant aus, können Änderungen seit der letzten erfolgreichen
Replikation fehlen.
Ceph verfolgt einen anderen Ansatz.
Bei Proxmox wird Ceph RBD typischerweise als verteilter Shared Block Storage
eingesetzt. Die virtuellen Datenträger liegen damit im Ceph-Cluster und sind
nicht fest an den lokalen Storage des gerade ausführenden Proxmox-Nodes gebunden.
Dadurch können die VM-Datenträger auch von anderen berechtigten Cluster-Nodes
erreicht werden.
Bei einem typischen replizierten Ceph-Pool mit
size=3 werden drei Instanzen eines RADOS-Objekts gespeichert.
Bei einer entsprechend konfigurierten CRUSH-Regel werden diese auf
unterschiedliche OSDs beziehungsweise Hosts verteilt.
Das bedeutet ausdrücklich nicht, dass sämtliche Daten auf jedem Node des
Clusters vollständig identisch vorhanden sein müssen.
Fällt ein Proxmox-Node aus, kann eine als HA-Ressource konfigurierte VM nach
dem erforderlichen Cluster- und Fencing-Prozess auf einem anderen verfügbaren
Node neu gestartet werden. Ihre virtuellen Datenträger bleiben über Ceph RBD
verfügbar, solange das Ceph-Cluster über ausreichend OSDs und Replikate für den
weiteren Betrieb verfügt.
Auch bei Migrationen bietet Shared Storage einen erheblichen Vorteil:
Die kompletten virtuellen Festplatten müssen nicht zwischen den
Virtualisierungs-Hosts kopiert werden, weil sie bereits über Ceph erreichbar
sind.
Beide Verfahren können für Proxmox-VE-Cluster sinnvoll sein. Die Entscheidung hängt vor allem von der gewünschten Verfügbarkeit, dem akzeptablen RPO, der Clustergröße, der vorhandenen Netzwerkinfrastruktur und der erforderlichen Storage-Performance ab.
| Merkmal | Ceph | ZFS-Replikation |
|---|---|---|
| Storage-Prinzip | Verteilter Shared Storage | Lokaler Storage mit Replikation |
| Datenverteilung | Kontinuierlich durch Ceph | Asynchron in definierten Intervallen |
| RPO bei Node-Ausfall | Bei intaktem Ceph keine periodische ZFS-Replikationslücke | Abhängig vom letzten erfolgreichen Replikationslauf |
| VM-Datenträger für andere Nodes erreichbar | Ja, über den gemeinsamen Ceph-Storage | Auf vorher definierten Replikationszielen vorhanden |
| Migration | Keine vollständige Übertragung des VM-Datenträgers zwischen den Nodes notwendig | Abhängig von Ziel-Node und Replikationsstatus |
| Netzwerkanforderungen | Hoch, insbesondere bei Replikation, Recovery und Rebalancing | Meist geringer und zeitlich steuerbarer |
| Komplexität | Höher | Geringer |
| Typischer Einsatz | Produktive HCI- und HA-Cluster mit gemeinsamem Storage | Kleinere Cluster und Umgebungen mit akzeptablem Replikations-RPO |
Beim Sizing eines hyperkonvergenten Proxmox-VE-Clusters müssen die Ressourcen
für Virtualisierung und Ceph gemeinsam betrachtet werden.
CPU, RAM, Storage-Kapazität, Anzahl der OSDs und Netzwerkbandbreite beeinflussen
sich gegenseitig.
CPU:
Ceph MON- und MGR-Dienste benötigen im Vergleich zu den eigentlichen
Storage-Diensten normalerweise relativ wenig CPU-Leistung.
Bei einem typischen Proxmox-Cluster mit Ceph RBD entsteht ein wesentlicher Teil
der Storage-Last auf den OSDs.
Deshalb müssen ausreichend CPU-Ressourcen für Ceph verfügbar bleiben und dürfen
nicht vollständig von virtuellen Maschinen belegt werden.
Ein Ceph Metadata Server (MDS) wird insbesondere für
CephFS benötigt. Für den typischen Block-I/O einer virtuellen
Maschine auf Ceph RBD befindet sich der MDS nicht im eigentlichen Datenpfad.
Wird CephFS zusätzlich verwendet, muss dessen MDS-Ressourcenbedarf gesondert
berücksichtigt werden.
RAM:
Der Arbeitsspeicherbedarf hängt unter anderem von Anzahl und Kapazität der OSDs,
dem verwendeten Storage, dem Workload und der Ceph-Konfiguration ab.
Der von Ceph benötigte RAM muss zusätzlich zum Speicherbedarf der virtuellen
Maschinen und Container eingeplant werden.
Ein Cluster, dessen RAM bereits vollständig durch VMs ausgeschöpft wird,
besitzt keine ausreichende Reserve für Storage-, Recovery- und Cluster-Prozesse.
Storage-Kapazität:
Bei der Planung darf nicht nur die theoretische Nutzkapazität betrachtet werden.
Bei einem replizierten Pool mit size=3 werden drei Instanzen
jedes Objekts gespeichert. Die reine Nutzkapazität liegt daher zunächst ungefähr
bei einem Drittel der Rohkapazität. Davon müssen zusätzliche Reserven für
Ausfälle, Recovery und Rebalancing abgezogen werden.
Fällt ein OSD aus, verteilt Ceph die betroffenen Daten entsprechend der
Cluster- und CRUSH-Konfiguration auf verfügbare OSDs. Dafür muss ausreichend
freier Speicher vorhanden sein.
Ein Cluster sollte daher nicht bis an seine technischen Fullness-Grenzen
herangefahren werden.
Ceph verwendet standardmäßig unter anderem folgende Schwellwerte:
nearfull: 85 % – Warnung vor zu hoher OSD-Auslastung
backfillfull: 90 % – kein neuer Backfill auf zu volle OSDs
full: 95 % – Schreibzugriffe werden zum Schutz des Clusters blockiert
Für die Praxis ist besonders wichtig:
Nicht nur die durchschnittliche Clusterauslastung betrachten.
Entscheidend kann der am stärksten belegte OSD sein.
Daher sollten OSD-Auslastung und Datenverteilung kontinuierlich überwacht werden.
Eine betriebliche Warnschwelle deutlich unterhalb der technischen
Ceph-Grenzwerte – beispielsweise im Bereich von etwa 70 bis 80 Prozent,
abhängig von Clustergröße und Ausfallszenario – schafft Reserve für
Rebalancing und den Ausfall eines OSDs oder Nodes.
Tipp:
Zusätzliche OSDs beziehungsweise weitere Storage-Kapazität können in ein
bestehendes Ceph-Cluster integriert werden. Ceph verteilt die Daten anschließend
entsprechend der Konfiguration neu.
Die Netzwerkinfrastruktur ist ein zentraler Bestandteil eines
Proxmox-Ceph-Clusters. Sie transportiert nicht nur den Datenverkehr der
virtuellen Maschinen, sondern auch Cluster-Kommunikation, Ceph-I/O,
Replikation, Recovery und Rebalancing.
Für produktive Ceph-Umgebungen ist 10 GbE eine sinnvolle technische
Basis. Bei hoher I/O-Last, schnellen NVMe-Datenträgern oder größeren
Clustern können 25, 40 oder 100 GbE sinnvoll sein.
Die konkrete Auslegung richtet sich nach Anzahl der Nodes, OSDs, Datenträgern
und den erwarteten Workloads.
Die Netzwerkverbindungen sollten redundant ausgeführt werden.
Der Ceph-Verkehr kann über separate physische Interfaces und Switches oder,
bei ausreichender Bandbreite und entsprechender Planung, logisch über VLANs
vom VM- und Management-Verkehr getrennt werden.
Bei der Beispielkonfiguration mit vier 10-GbE-Ports pro Server können zwei
Verbindungen für Ceph und zwei weitere für VM-, Management- oder
Cluster-Verkehr eingeplant werden.
Bei einer vollständig redundanten Architektur werden die Verbindungen auf
unterschiedliche Switches verteilt.
Für einen kleinen 3-Node-Cluster sind unter bestimmten Voraussetzungen auch
Direct-Attached-Verbindungen für dedizierte Storage-Kommunikation möglich.
Für größere oder später erweiterbare Cluster ist eine switchbasierte
Netzwerkarchitektur normalerweise flexibler.
Cluster erweitern:
Mehr Storage-Kapazität kann durch zusätzliche oder größere OSDs bereitgestellt
werden. Bei einem steigenden Kapazitäts- oder Performancebedarf können auch
weitere Proxmox-/Ceph-Nodes ergänzt werden.
Die Anzahl der Laufwerksschächte sollte deshalb bereits beim ersten Sizing
berücksichtigt werden.
Benötigt ein Projekt deutlich mehr Kapazität, können beispielsweise
2-HE-Systeme mit 24 oder mehr SSD-/NVMe-Slots zum Einsatz kommen.
Auch HDDs können technisch als Ceph-OSDs genutzt werden.
Für normale produktive Virtualisierungs-Workloads empfehlen sich jedoch
typischerweise Enterprise-SSDs oder NVMe-Medien.
Für große Datenmengen mit geringeren IOPS-Anforderungen können separate
Storage-Tiers oder externe NAS-/SAN-Systeme je nach Anwendung wirtschaftlicher
sein.
Auf einem Proxmox-VE-Cluster können neue virtuelle Maschinen und Container erstellt oder bestehende Workloads aus anderen Virtualisierungsumgebungen migriert werden. Je nach Ausgangssystem unterstützen wir auch die Migration von VMware vSphere/ESXi und Microsoft Hyper-V zu Proxmox VE.
Linux Server als virtuelle Maschine neu erstellen
Windows Server 2022 als virtuelle Maschine neu erstellen
Ein leistungsfähiges Proxmox-Ceph-System besteht nicht nur aus Servern und
Software. Entscheidend sind eine passende Architektur und eine auf den
Workload abgestimmte Konfiguration.
Je nach vereinbartem Projektumfang unterstützen wir Sie unter anderem bei:
Anforderungsanalyse und Hardware-Sizing
Planung von CPU, RAM, OSDs und nutzbarer Ceph-Kapazität
Planung der 10/25/100-GbE-Netzwerkinfrastruktur
Vorbereitung und Grundinstallation von Proxmox VE
Aufbau und Konfiguration des Proxmox-VE-Clusters
Installation und Konfiguration von Ceph
Einrichtung von Ceph RBD und HA-Ressourcen
Konfiguration der Storage- und Netzwerkpfade
Integration eines Proxmox Backup Servers
Migration bestehender virtueller Maschinen
Migration von VMware oder Hyper-V zu Proxmox VE
Dokumentation der Umgebung
Schulung und Einweisung der Administratoren
Remote- oder Vor-Ort-Inbetriebnahme
Wie bei unseren anderen Systemlösungen kann die Hardware vor der endgültigen Inbetriebnahme geprüft und grundkonfiguriert werden. Der konkrete Leistungsumfang wird im Angebot passend zum Projekt festgelegt.
Für einen produktiven hyperkonvergenten Proxmox-VE-Cluster mit Ceph werden in der Praxis mindestens drei Nodes empfohlen. Damit können Ceph-Dienste redundant verteilt und replizierte Pools mit mehreren Kopien auf unterschiedlichen Hosts aufgebaut werden. Bei höheren Anforderungen an Verfügbarkeit, Kapazität oder Performance können weitere Nodes sinnvoll sein.
Ceph stellt einen verteilten Shared Storage bereit, auf den die Proxmox-Nodes gemeinsam zugreifen können. ZFS wird bei Proxmox häufig als lokaler Storage eingesetzt. VM-Daten können mit Proxmox Storage Replication asynchron auf andere ZFS-Nodes übertragen werden. Dadurch besteht zwischen zwei Replikationsläufen ein mögliches RPO.
Ja. Hochverfügbarkeit kann unter Proxmox VE auch mit lokalem Storage und Storage Replication genutzt werden. Bei asynchroner ZFS-Replikation können bei einem ungeplanten Node-Ausfall jedoch Änderungen seit der letzten erfolgreichen Replikation fehlen. Ceph vermeidet diese periodische Replikationslücke, weil die VM-Datenträger bereits auf einem verteilten Shared Storage liegen.
Dafür gibt es keinen einzigen pauschalen Wert. Der RAM-Bedarf hängt unter anderem von Anzahl und Größe der OSDs, der Ceph-Konfiguration, den verwendeten Datenträgern und dem Workload ab. Zusätzlich muss der Arbeitsspeicher für die virtuellen Maschinen und Container eingeplant werden. Für produktive Cluster ist deshalb eine ausreichende RAM-Reserve wichtig.
Für produktive Ceph-Cluster ist 10 GbE eine sinnvolle Basis. Bei schneller All-Flash- oder NVMe-Ausstattung, hoher I/O-Last oder größeren Clustern können 25 oder 100 GbE sinnvoll sein. Das Netzwerk sollte redundant ausgelegt und für Ceph-Replikation, Recovery und Rebalancing ausreichend dimensioniert werden.
Bei einem replizierten Pool mit size=3 werden drei Instanzen eines Objekts gespeichert. Rein rechnerisch steht daher ungefähr ein Drittel der Rohkapazität für Nutzdaten zur Verfügung. In der Praxis muss zusätzlich freie Kapazität für Recovery, Rebalancing, OSD-Ausfälle und die Ceph-Fullness-Grenzwerte reserviert werden.
Ist eine virtuelle Maschine als HA-Ressource konfiguriert und das Ceph-Cluster weiterhin funktionsfähig, kann Proxmox VE die VM nach der Erkennung und Absicherung des ausgefallenen Nodes auf einem anderen verfügbaren Cluster-Node neu starten. Da die virtuellen Datenträger über Ceph RBD erreichbar sind, müssen sie nicht zuvor auf den neuen Virtualisierungs-Host kopiert werden.
Ja. Zusätzliche OSDs, größere Datenträger und weitere Cluster-Nodes können abhängig von der vorhandenen Architektur ergänzt werden. Ceph verteilt die Daten anschließend entsprechend der Cluster-Konfiguration neu. Eine geplante Erweiterbarkeit sollte bereits bei Servergehäusen, Netzwerkports und Switch-Kapazitäten berücksichtigt werden.
Ja. Virtuelle Maschinen aus VMware-vSphere-/ESXi- und Microsoft-Hyper-V- Umgebungen können grundsätzlich nach Proxmox VE migriert werden. Das genaue Vorgehen hängt vom Quellsystem, Gastbetriebssystem, Storage, Netzwerk und der akzeptablen Ausfallzeit ab. Wir unterstützen bei Planung und Durchführung der Migration.
Für produktive Umgebungen kommen vor allem Basic, Standard und Premium infrage. Die Funktionen von Proxmox VE sind nicht auf bestimmte Subscription-Stufen beschränkt. Die Stufen unterscheiden sich insbesondere bei Anzahl der Support-Tickets, Reaktionszeiten und weiteren Support-Leistungen. Für geschäftskritische Infrastrukturen sollte der benötigte Support-Level bereits in der Planungsphase festgelegt werden.
Weitere Informationen erhalten Sie hier. Oder setzen Sie sich mit unserem Vertrieb in Verbindung, entweder per E-Mail oder unter Telefon 04185 / 707 85 0.

| Telefon: | 04185 / 707 85 0 |
vCard der Stor IT Back GmbH & Co. KG: |
|
| Fax: | 04185 / 707 59 43 | ||
| E-Mail: | info@storitback.de |


